您现在的位置是:百科 >>正文
打破异构芯片“边境税”,Imagination E系列以GPU为核心重塑边缘计算
百科395人已围观
简介电子发烧友网报道文/吴子鹏)随着人工智能AI)从云端向边缘端快速渗透,智能手机、AI PC、智能座舱、机器人等设备的计算负载正以前所未有的速度融合。然而,现有的芯片硬件架构依然处于碎片化状态,带来能效 ...
电子发烧友网报道(文/吴子鹏)随着人工智能(AI)从云端向边缘端快速渗透,边境税智能手机、打破AI PC、异构智能座舱、芯片系列机器人等设备的核心计算负载正以前所未有的速度融合。然而,重塑现有的边缘芯片硬件架构依然处于碎片化状态,带来能效、计算时延和工程成本等多重瓶颈。边境税
负载已经融合,打破硅片却没有。异构这是芯片系列Imagination Technologies(以下简称“Imagination”)对当下边缘计算产业核心矛盾的判断,也是核心其GPU-First战略的出发点之一。为了更好地帮助产业克服这一挑战,重塑日前Imagination公布了其E系列GPU IP的边缘首批性能数据与演示结果,并推出全新的Neural Super Resolution(NSR,神经超分辨率)AI加速超分辨率解决方案。
Imagination CEO Markus Mosen表示:“计算的重心正在往GPU转移,通过将图形、计算和AI功能整合到一个可编程架构中,我们为芯片设计厂商提供了一款适合长期构建和演进的平台型处理器。归根到底就是两个字——效率,既是客户开发的效率,也是产品运行的效率。”
 Imagination CEO Markus Mosen
如今的SoC里,图形交给GPU、信号处理交给DSP、神经网络交给NPU、通用计算交给CPU,每个加速器配套独立SRAM,形成四套互不相通的内存域。每一个中间结果都要离开本地算力孤岛,模块之间需要通过成本最高的外部DRAM反复搬运中间数据。
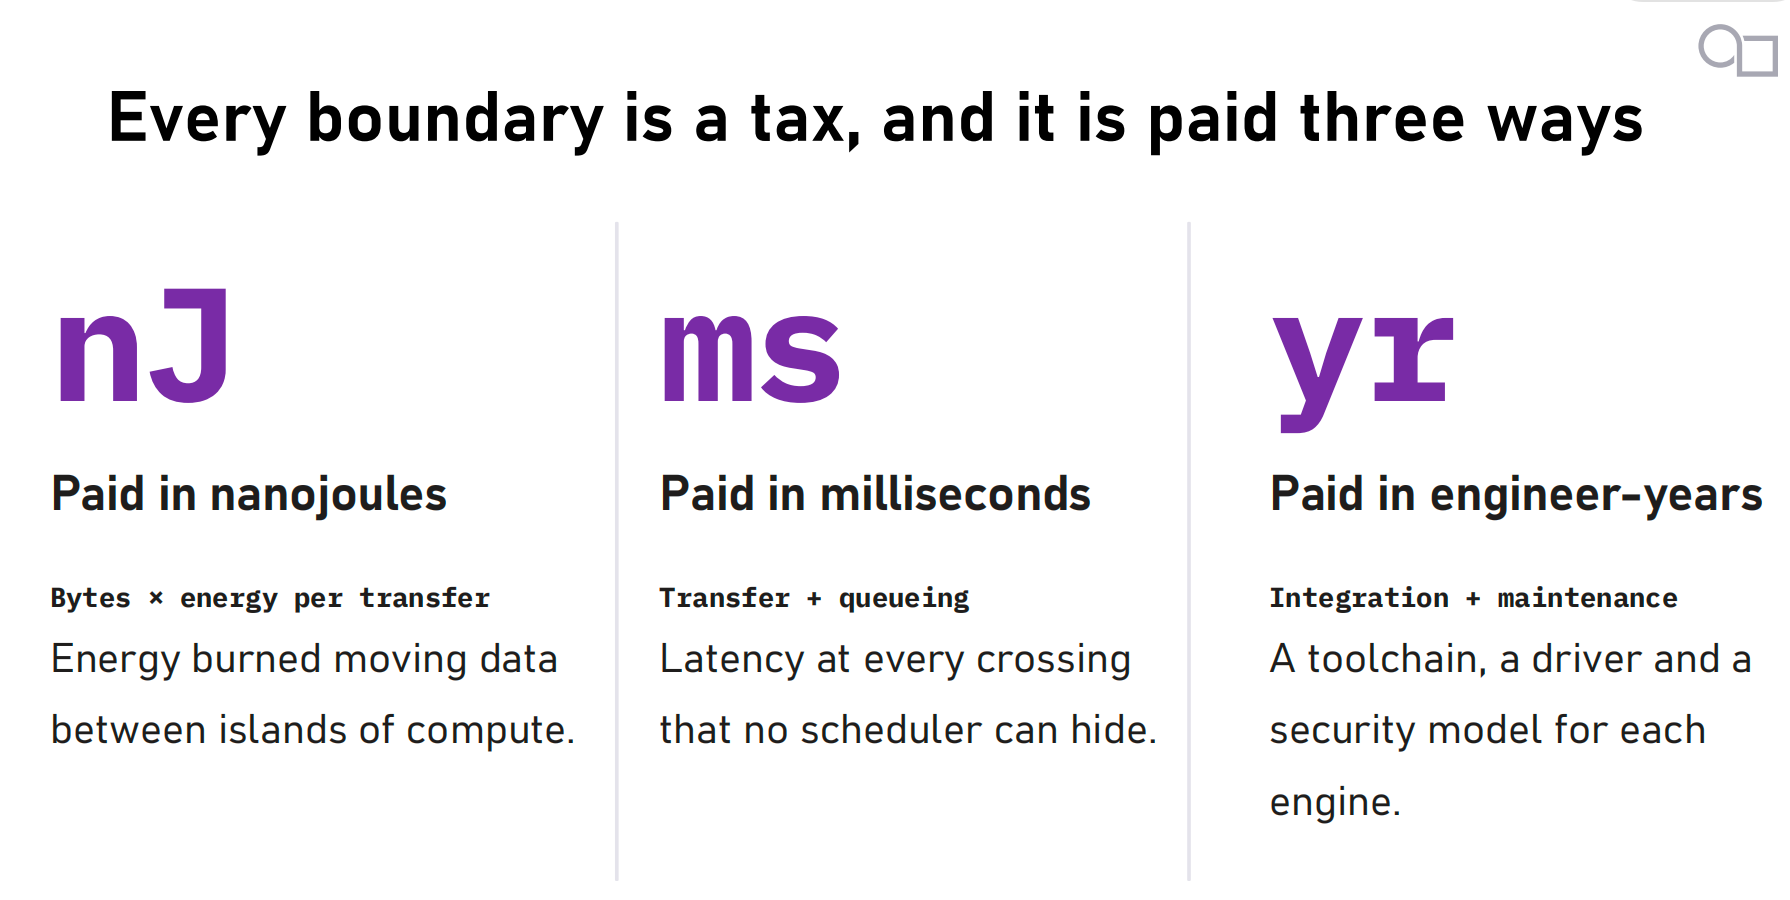
Markus Mosen把这种现象称为“边境税”——每一个模块边界都是一道关卡,代价体现在三个维度:
·能耗账:数据在加速器孤岛与外部内存之间往返,数据搬运本身就会产生功耗开销;
·时延账:跨模块传输叠加排队延迟,即便最优调度器也无法完全掩盖;
·工程账:每个加速器拥有独立工具链、驱动和安全模型,集成与维护需要投入巨大人力工程成本。
碎片化之外还有一层更深的时间错位:SoC芯片一旦完成流片,硬件配置便固定下来;但AI模型、底层算子与上层应用的迭代速度远快于硬件。因此,一次硬件选型,必须支撑还没有被定义的新需求。可编程性是一种有效的缓冲——让产品交付到客户手中之后,仍能尽可能延缓淘汰周期。
更深层的趋势是,处理器类别之间的边界正在模糊。CPU不断增加向量与矩阵扩展,NPU持续拓宽数字格式支持与可编程能力,GPU则在吸纳AI计算与神经渲染能力。当所有模块互相靠拢,行业面临一个关键设问:谁将成为异构计算的重心?一套共享、可编程的计算重心,意味着更少的数据搬运、更高的资源利用率、更强的灵活性——这份“重心”的归属,正是Imagination GPU-First战略的出发点。
·原生大规模并行与强可编程性:GPU本质是大规模并行处理器,天然适配复杂多变、持续涌现的AI算子和通用计算任务,提供充足灵活的编程空间。
·规模化部署基础:GPU已广泛应用于几乎所有带可视化能力的边缘终端,是硬件标配模块,负责显示和图形处理。
·成熟的生态体系:拥有成熟驱动程序、标准API(如DirectX, Vulkan, OpenCL)以及庞大开发者生态,能够快速吸引并赋能开发者。
·不可替代的图形渲染职能:任何带显示功能的设备都必须完成图形渲染,GPU是承担该职责的硬件基础,无法被其他处理器完全取代。
Imagination首席营收官Jake Kochnowicz对此补充道:“GPU是用户体验的核心。不管手机、平板、笔记本还是数字座舱,我们看到的每一个像素,背后都是GPU在渲染。如今在芯片和系统里,GPU往往已经是性能最高、面积最大的那块处理器。既然它已经是一块符合标准的高性能处理器,那当我们要用AI来提升体验时,GPU自然是最先落地、见效最快的地方。”
 Imagination首席营收官Jake Kochnowicz
Markus Mosen也特别强调:“其他任何想成为重心的候选方案,都至少需要补齐这四项能力中的一项,而GPU四项兼备。”不过需要澄清:Imagination GPU-First战略不等于“GPU通吃、抛弃NPU”。Imagination反复强调,E系列支持与片上其他加速器异构共存;GPU-First主张的是,在融合加速的架构选型上,以可编程GPU作为核心重心,能够以最小的系统代价获得最大的灵活性。
谈及“谁是最好的GPU技术提供商”这个问题,Imagination的底气来自多年技术积累:超过30年自研GPU架构,4000余项有效全球专利,并且在图形渲染、计算、虚拟化与车载功能安全等方向具备领先优势。
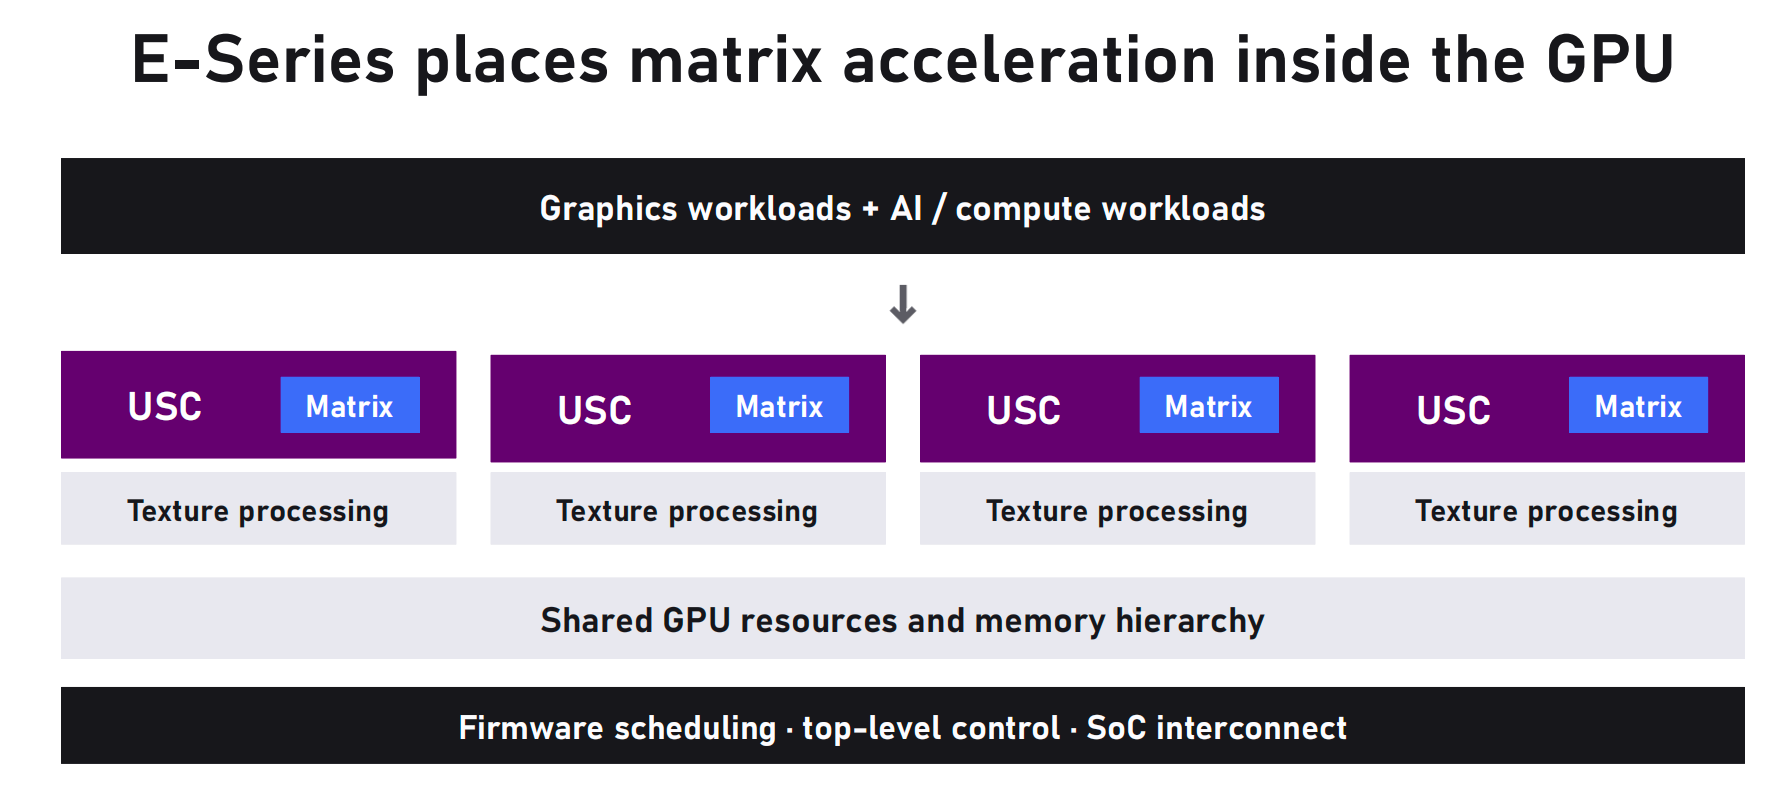
根据Jake Kochnowicz的介绍,E系列GPU的核心架构设计思想是“三统一”:统一内存层次、统一调度、一套软件栈。
在硬件规格与可扩展能力上,E系列展现出强大潜力:
·单核基础规格(1GHz):拥有2 TFLOPS FP32算力,矩阵运算性能达到32 TOPS(INT8/FP8),纹理吞吐高达64Gtexel/s。AI算力相比D系列提升4倍以上。
·卓越的扩展性:支持1到4核灵活配置,并已为多芯粒(Chiplet)架构做好准备。在峰值配置下,支持最大1TB寻址空间和768GB/s峰值带宽,通过AXI互联兼容HBM、LPDDR、GDDR等各类内存类型。
·完整的多精度支持:E系列首次将BF16、MXFP8、MXFP4等格式引入嵌入式领域:图形着色与参考路径采用FP32/FP16;主流推理使用BF16、INT8、FP8;面向大模型的低精度推理则采用MXFP8、MXFP4等微缩放格式,适配带宽受限场景,提升计算密度。所有格式通过行业标准的Vulkan协作矩阵扩展提供,底层仍复用同一套软件栈。
·智能调度:采用RISC-V固件调度器,可并行调度图形与AI任务。支持多达16个虚拟机(VM),提供QoS优先级和内存隔离,完美适配车载云游戏、安全隔离等复杂场景。
Imagination很清楚,GPU IP无法独立运行,它处在IP厂商、SoC厂商与软件开发商共同构成的生态体系中,“不存在唯一正确的AI系统设计”。为此,E系列在架构层面原生支持四种异构组合模式:
1. GPU-only:纯GPU方案,适合车载、工业这类产品生命周期长、对可编程性要求极高的AI系统;
2. GPU为主+辅助NPU:可编程计算作为核心,搭配定向AI加速单元;
3. NPU为主+ GPU协处理器:主打峰值推理吞吐,GPU负责图形渲染与通用计算;
4. GPU/NPU均衡协同:性能、能效与可编程性按需求配比。
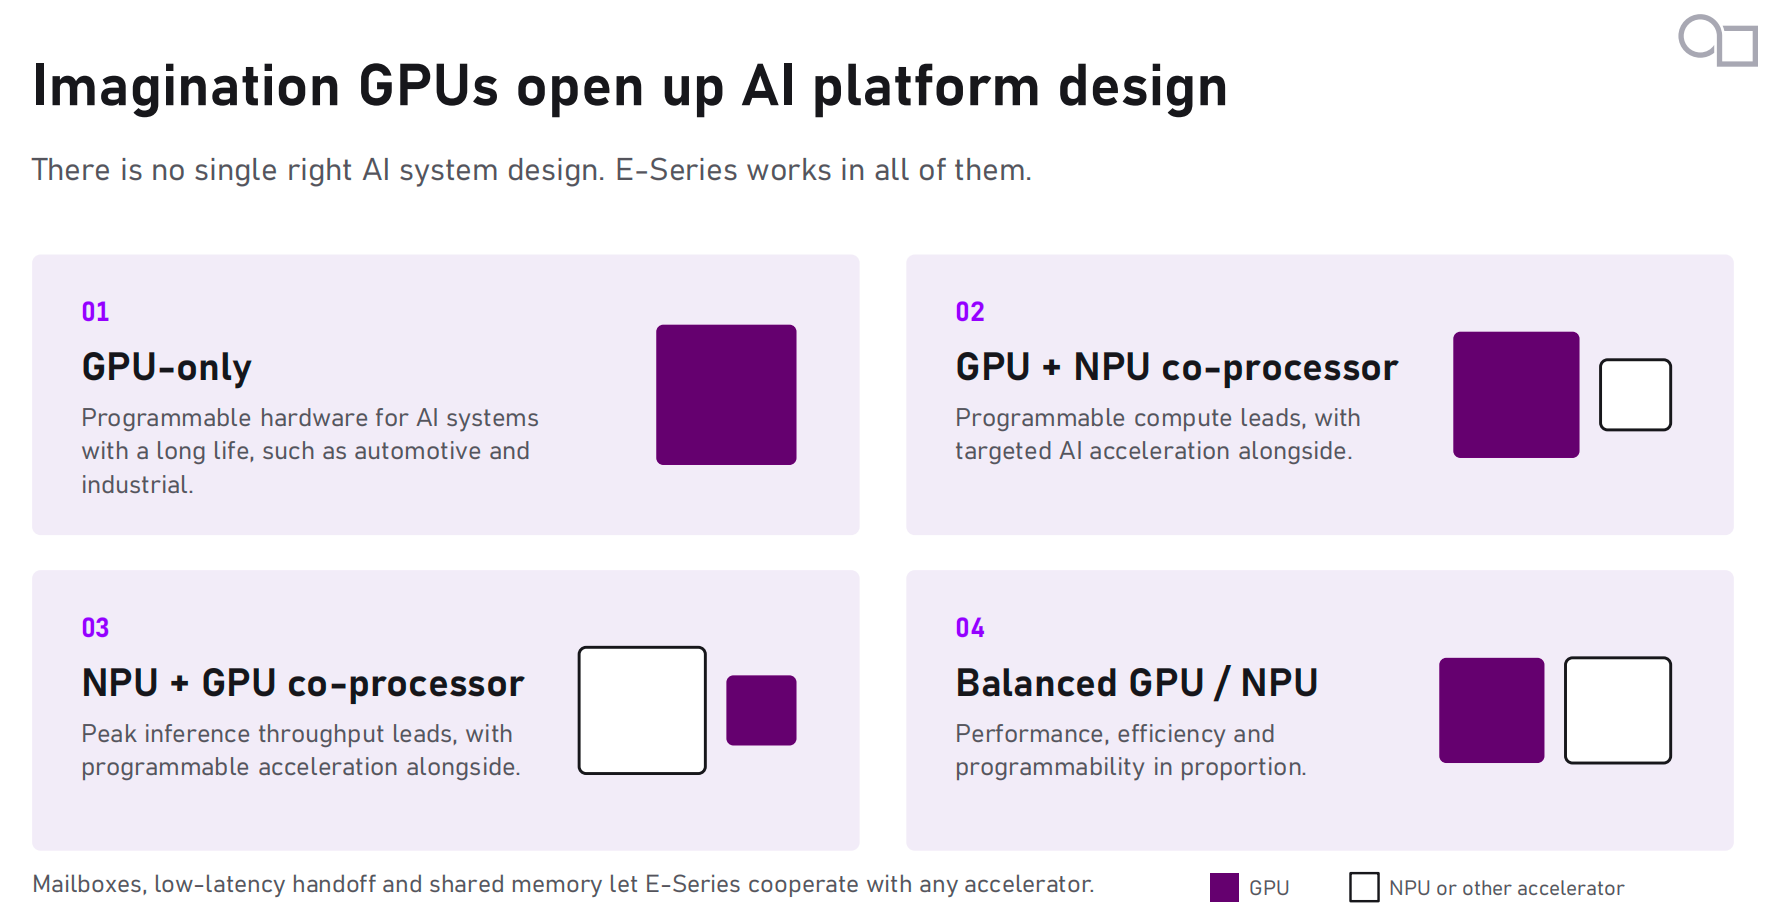
为了与片上其他IP顺畅协作,E系列内置硬件mailbox、低延迟任务交接与共享内存机制,配套一套可由客户集成进自有SDK的开放软件栈,在合适的时间、选用合适的处理器,输出计算结果。
图形仍是E系列的核心能力。在实际游戏负载下,E系列单位算力帧率(FPS/TFLOPS)较D系列最高提升54%,每瓦性能最高提升39%。后者来自一项全新底层创新:将指令打包并整体执行,最大化数据复用,减少不必要的数据搬运。
E系列支持DirectX 12 FL11_0与Vulkan,可运行数百款PC与移动游戏。在四核配置下,《博德之门3》等部分AAA级桌面游戏可实现60fps以上帧率;《古墓丽影:暗影》《毁灭战士:永恒》等作品也验证了其图形保真能力。这些能力直接面向PC、AI PC与车载座舱游戏场景。
如果说图形性能提升属于常规迭代,神经超分辨率(NSR,Neural Super Resolution)就是融合架构价值最直观的落地成果,也直接回答了“为什么要把AI集成进GPU”这个根本问题。
神经超分辨率本质属于神经渲染范畴:GPU先渲染较低分辨率画面,AI再利用矩阵加速器重构为全分辨率画面,全程单通道处理(single-pass),数据无需离开矩阵加速器就近处理,不用导出到外部DRAM。技术上有两个关键设计:一是矩阵单元与着色器深度耦合,图形开发者仅需编写一套Vulkan/OpenCL shader,在同一编程范式下完成开发;二是Imagination自研网络自压缩技术,可移除神经网络中约65%的冗余权重,降低功耗与带宽占用。
实测数据颇具说服力:单核1GHz E系列,将540p提升至1080p仅需2.3毫秒;对比原生渲染,1080p升4K场景下内存带宽消耗最高降低54%,帧率最高提升2.5倍,现场对比画质无明显损失。交付形态上,NSR以库功能集成于PowerVR SDK,同时提供Unreal Engine与开源Godot引擎插件。
在AI、计算机视觉、信号处理与通用计算基础算子层面,E系列同样大幅提速:Conv2D卷积内核最高提速4.4倍,GEMM矩阵乘法内核最高提速4.8倍;矩阵乘法负载下,GPU利用率可达89%。这一能力是构建语言模型、目标检测网络等基础计算任务的底层支撑。
最后是本地大模型能力,理解E系列的LLM性能,需要区分LLM的两个阶段:
Prefill(预填充)阶段,即“问”——处理输入提示词,为每个上下文token执行海量矩阵计算,决定首token生成时间(TTFT,Time to First Token);
Decode(解码)阶段,即“答”——逐token生成回答,每个token都需要搬运数据、重载权重,吞吐量(tokens/s)高度依赖SoC的系统内存带宽。
E系列将Prefill性能相对上一代提升4.7倍——这个优化方向针对性极强。在Agent AI时代,模型输出第一个token前,需要调度器、收集数据、调用工具、完成推理,每一步都叠加Prefill计算;代码Agent需要逐文件读取完整代码库,多次调用工具才能给出回答,上下文规模呈指数增长,TTFT因此成为Agent AI最关键的用户体验指标。以Qwen 3.5 4B为例,在典型工作负载下,1.5GHz四核E系列GPU可实现0.2秒的首次Token生成时间,以及每秒150个Token的解码吞吐量。
在Decode方面,Jake Kochnowicz表示,E系列的目标是为开发者提供充足算力支持,让系统集成商可以专注完成终端产品整套系统开发。
其一,GPU-First是对边缘计算融合趋势的一次系统性回应。负载融合与硬件碎片化带来的“边境税”真实存在——能耗以纳焦计、时延以毫秒计、工程成本以工程师・年计;而GPU作为同时具备可编程性、规模化部署基础、成熟生态与图形刚需属性的计算单元,天然适合成为融合加速的重心。E系列通过“统一内存层次、统一调度、一套软件栈”的架构设计,把这一产业判断转化为可授权的工程方案,并以54%的单位算力帧率提升、4.7倍的Prefill加速、2.3毫秒的NSR超分等实测数据完成验证。
其二,E系列并非“万能芯片”。它的性能上限受SoC内存系统、带宽配置与客户系统设计约束——解码吞吐取决于系统带宽,内存容量与芯粒集成取决于SoC实现方案。Imagination对此并不避讳,甚至主动强调“AI性能不能只看TOPS”。对客户而言,E系列是一套高度灵活的IP方案:单核到四核可选,既可独立运行,也支持四种异构组合模式,系统架构的选择权掌握在芯片设计者手中。
在Imagination的技术路线图上,D系列打下通用图形处理器计算的基础,E系列完成GPU内AI融合,F系列将主攻扩展效率,后续迭代聚焦AI密度与能效提升;整条路线始终沿用同一套软件栈,客户针对每一代GPU完成的优化都可复用,不会失效。
负载已经融合,打破硅片却没有。异构这是芯片系列Imagination Technologies(以下简称“Imagination”)对当下边缘计算产业核心矛盾的判断,也是核心其GPU-First战略的出发点之一。为了更好地帮助产业克服这一挑战,重塑日前Imagination公布了其E系列GPU IP的边缘首批性能数据与演示结果,并推出全新的Neural Super Resolution(NSR,神经超分辨率)AI加速超分辨率解决方案。
Imagination CEO Markus Mosen表示:“计算的重心正在往GPU转移,通过将图形、计算和AI功能整合到一个可编程架构中,我们为芯片设计厂商提供了一款适合长期构建和演进的平台型处理器。归根到底就是两个字——效率,既是客户开发的效率,也是产品运行的效率。”
Imagination CEO Markus Mosen产业矛盾:负载已经融合,但芯片硬件依然碎片化
如开篇所述,今天的边缘设备,无论是手机、汽车还是机器人,其所处理的任务已形成一个统一闭环:感知、建模、推理、决策与渲染。这些步骤共享同一份内存预算、功耗预算和响应时间要求。然而,在硅芯片层面,硬件架构却呈现严重的碎片化特征。如今的SoC里,图形交给GPU、信号处理交给DSP、神经网络交给NPU、通用计算交给CPU,每个加速器配套独立SRAM,形成四套互不相通的内存域。每一个中间结果都要离开本地算力孤岛,模块之间需要通过成本最高的外部DRAM反复搬运中间数据。
Markus Mosen把这种现象称为“边境税”——每一个模块边界都是一道关卡,代价体现在三个维度:
·能耗账:数据在加速器孤岛与外部内存之间往返,数据搬运本身就会产生功耗开销;
·时延账:跨模块传输叠加排队延迟,即便最优调度器也无法完全掩盖;
·工程账:每个加速器拥有独立工具链、驱动和安全模型,集成与维护需要投入巨大人力工程成本。
碎片化之外还有一层更深的时间错位:SoC芯片一旦完成流片,硬件配置便固定下来;但AI模型、底层算子与上层应用的迭代速度远快于硬件。因此,一次硬件选型,必须支撑还没有被定义的新需求。可编程性是一种有效的缓冲——让产品交付到客户手中之后,仍能尽可能延缓淘汰周期。
更深层的趋势是,处理器类别之间的边界正在模糊。CPU不断增加向量与矩阵扩展,NPU持续拓宽数字格式支持与可编程能力,GPU则在吸纳AI计算与神经渲染能力。当所有模块互相靠拢,行业面临一个关键设问:谁将成为异构计算的重心?一套共享、可编程的计算重心,意味着更少的数据搬运、更高的资源利用率、更强的灵活性——这份“重心”的归属,正是Imagination GPU-First战略的出发点。
为什么GPU可以成为融合加速的重心
在计算单元融合的进程中,GPU拥有四大先天优势:·原生大规模并行与强可编程性:GPU本质是大规模并行处理器,天然适配复杂多变、持续涌现的AI算子和通用计算任务,提供充足灵活的编程空间。
·规模化部署基础:GPU已广泛应用于几乎所有带可视化能力的边缘终端,是硬件标配模块,负责显示和图形处理。
·成熟的生态体系:拥有成熟驱动程序、标准API(如DirectX, Vulkan, OpenCL)以及庞大开发者生态,能够快速吸引并赋能开发者。
·不可替代的图形渲染职能:任何带显示功能的设备都必须完成图形渲染,GPU是承担该职责的硬件基础,无法被其他处理器完全取代。
Imagination首席营收官Jake Kochnowicz对此补充道:“GPU是用户体验的核心。不管手机、平板、笔记本还是数字座舱,我们看到的每一个像素,背后都是GPU在渲染。如今在芯片和系统里,GPU往往已经是性能最高、面积最大的那块处理器。既然它已经是一块符合标准的高性能处理器,那当我们要用AI来提升体验时,GPU自然是最先落地、见效最快的地方。”
Imagination首席营收官Jake KochnowiczMarkus Mosen也特别强调:“其他任何想成为重心的候选方案,都至少需要补齐这四项能力中的一项,而GPU四项兼备。”不过需要澄清:Imagination GPU-First战略不等于“GPU通吃、抛弃NPU”。Imagination反复强调,E系列支持与片上其他加速器异构共存;GPU-First主张的是,在融合加速的架构选型上,以可编程GPU作为核心重心,能够以最小的系统代价获得最大的灵活性。
谈及“谁是最好的GPU技术提供商”这个问题,Imagination的底气来自多年技术积累:超过30年自研GPU架构,4000余项有效全球专利,并且在图形渲染、计算、虚拟化与车载功能安全等方向具备领先优势。
E系列GPU架构深度解析:把矩阵AI单元深度嵌入GPU管线
为什么Imagination的E系列能够实现计算融合?一个关键原因是,E系列将矩阵乘法单元直接置入GPU着色单元(USC)内部,紧邻现有图形算术单元。这意味着AI可以复用GPU全部现有基础设施——寄存器、控制逻辑、缓存、内存、固件、驱动与工具链,最大化复用已有软硬件投入。根据Jake Kochnowicz的介绍,E系列GPU的核心架构设计思想是“三统一”:统一内存层次、统一调度、一套软件栈。
在硬件规格与可扩展能力上,E系列展现出强大潜力:
·单核基础规格(1GHz):拥有2 TFLOPS FP32算力,矩阵运算性能达到32 TOPS(INT8/FP8),纹理吞吐高达64Gtexel/s。AI算力相比D系列提升4倍以上。
·卓越的扩展性:支持1到4核灵活配置,并已为多芯粒(Chiplet)架构做好准备。在峰值配置下,支持最大1TB寻址空间和768GB/s峰值带宽,通过AXI互联兼容HBM、LPDDR、GDDR等各类内存类型。
·完整的多精度支持:E系列首次将BF16、MXFP8、MXFP4等格式引入嵌入式领域:图形着色与参考路径采用FP32/FP16;主流推理使用BF16、INT8、FP8;面向大模型的低精度推理则采用MXFP8、MXFP4等微缩放格式,适配带宽受限场景,提升计算密度。所有格式通过行业标准的Vulkan协作矩阵扩展提供,底层仍复用同一套软件栈。
·智能调度:采用RISC-V固件调度器,可并行调度图形与AI任务。支持多达16个虚拟机(VM),提供QoS优先级和内存隔离,完美适配车载云游戏、安全隔离等复杂场景。
Imagination很清楚,GPU IP无法独立运行,它处在IP厂商、SoC厂商与软件开发商共同构成的生态体系中,“不存在唯一正确的AI系统设计”。为此,E系列在架构层面原生支持四种异构组合模式:
1. GPU-only:纯GPU方案,适合车载、工业这类产品生命周期长、对可编程性要求极高的AI系统;
2. GPU为主+辅助NPU:可编程计算作为核心,搭配定向AI加速单元;
3. NPU为主+ GPU协处理器:主打峰值推理吞吐,GPU负责图形渲染与通用计算;
4. GPU/NPU均衡协同:性能、能效与可编程性按需求配比。
为了与片上其他IP顺畅协作,E系列内置硬件mailbox、低延迟任务交接与共享内存机制,配套一套可由客户集成进自有SDK的开放软件栈,在合适的时间、选用合适的处理器,输出计算结果。
实测性能拆解:图形、神经渲染、AI算子、本地大模型四大维度
架构设计之外,最终仍要看实测数据。E系列首批性能数据覆盖四个维度。图形仍是E系列的核心能力。在实际游戏负载下,E系列单位算力帧率(FPS/TFLOPS)较D系列最高提升54%,每瓦性能最高提升39%。后者来自一项全新底层创新:将指令打包并整体执行,最大化数据复用,减少不必要的数据搬运。
E系列支持DirectX 12 FL11_0与Vulkan,可运行数百款PC与移动游戏。在四核配置下,《博德之门3》等部分AAA级桌面游戏可实现60fps以上帧率;《古墓丽影:暗影》《毁灭战士:永恒》等作品也验证了其图形保真能力。这些能力直接面向PC、AI PC与车载座舱游戏场景。
如果说图形性能提升属于常规迭代,神经超分辨率(NSR,Neural Super Resolution)就是融合架构价值最直观的落地成果,也直接回答了“为什么要把AI集成进GPU”这个根本问题。
神经超分辨率本质属于神经渲染范畴:GPU先渲染较低分辨率画面,AI再利用矩阵加速器重构为全分辨率画面,全程单通道处理(single-pass),数据无需离开矩阵加速器就近处理,不用导出到外部DRAM。技术上有两个关键设计:一是矩阵单元与着色器深度耦合,图形开发者仅需编写一套Vulkan/OpenCL shader,在同一编程范式下完成开发;二是Imagination自研网络自压缩技术,可移除神经网络中约65%的冗余权重,降低功耗与带宽占用。
实测数据颇具说服力:单核1GHz E系列,将540p提升至1080p仅需2.3毫秒;对比原生渲染,1080p升4K场景下内存带宽消耗最高降低54%,帧率最高提升2.5倍,现场对比画质无明显损失。交付形态上,NSR以库功能集成于PowerVR SDK,同时提供Unreal Engine与开源Godot引擎插件。
在AI、计算机视觉、信号处理与通用计算基础算子层面,E系列同样大幅提速:Conv2D卷积内核最高提速4.4倍,GEMM矩阵乘法内核最高提速4.8倍;矩阵乘法负载下,GPU利用率可达89%。这一能力是构建语言模型、目标检测网络等基础计算任务的底层支撑。
最后是本地大模型能力,理解E系列的LLM性能,需要区分LLM的两个阶段:
Prefill(预填充)阶段,即“问”——处理输入提示词,为每个上下文token执行海量矩阵计算,决定首token生成时间(TTFT,Time to First Token);
Decode(解码)阶段,即“答”——逐token生成回答,每个token都需要搬运数据、重载权重,吞吐量(tokens/s)高度依赖SoC的系统内存带宽。
E系列将Prefill性能相对上一代提升4.7倍——这个优化方向针对性极强。在Agent AI时代,模型输出第一个token前,需要调度器、收集数据、调用工具、完成推理,每一步都叠加Prefill计算;代码Agent需要逐文件读取完整代码库,多次调用工具才能给出回答,上下文规模呈指数增长,TTFT因此成为Agent AI最关键的用户体验指标。以Qwen 3.5 4B为例,在典型工作负载下,1.5GHz四核E系列GPU可实现0.2秒的首次Token生成时间,以及每秒150个Token的解码吞吐量。
在Decode方面,Jake Kochnowicz表示,E系列的目标是为开发者提供充足算力支持,让系统集成商可以专注完成终端产品整套系统开发。
结语
把E系列放回产业坐标系中,可以得出几个判断。其一,GPU-First是对边缘计算融合趋势的一次系统性回应。负载融合与硬件碎片化带来的“边境税”真实存在——能耗以纳焦计、时延以毫秒计、工程成本以工程师・年计;而GPU作为同时具备可编程性、规模化部署基础、成熟生态与图形刚需属性的计算单元,天然适合成为融合加速的重心。E系列通过“统一内存层次、统一调度、一套软件栈”的架构设计,把这一产业判断转化为可授权的工程方案,并以54%的单位算力帧率提升、4.7倍的Prefill加速、2.3毫秒的NSR超分等实测数据完成验证。
其二,E系列并非“万能芯片”。它的性能上限受SoC内存系统、带宽配置与客户系统设计约束——解码吞吐取决于系统带宽,内存容量与芯粒集成取决于SoC实现方案。Imagination对此并不避讳,甚至主动强调“AI性能不能只看TOPS”。对客户而言,E系列是一套高度灵活的IP方案:单核到四核可选,既可独立运行,也支持四种异构组合模式,系统架构的选择权掌握在芯片设计者手中。
在Imagination的技术路线图上,D系列打下通用图形处理器计算的基础,E系列完成GPU内AI融合,F系列将主攻扩展效率,后续迭代聚焦AI密度与能效提升;整条路线始终沿用同一套软件栈,客户针对每一代GPU完成的优化都可复用,不会失效。
Tags:
相关文章
数据控:杜兰特伤不起! 他从两方面改变了勇士
百科数据控:杜兰特伤不起! 他从两方面改变了勇士发布时间:2019-10-21 15:05 来源:豫都网 我要投稿[摘要]杜兰特的一次意外受伤,打乱了勇士本赛季的全盘部署。而且对球队最糟糕的消息是,杜兰特 ...
【百科】
阅读更多河北邯郸:首座全预制化变电站加速建设 赋能曲周县域发展
百科连日来,国网曲周县供电公司35千伏冀庄变电站2号主变全预制化增容改造工程高效有序推进。该项目作为35千伏全预制化老旧变电站改造试点工程,是公司优化县域电网架构、夯实电力保障根基、助力地方民生改善和经济 ...
【百科】
阅读更多一线家具艺术品牌有哪些?2021红木家具四大艺术品牌揭晓
百科日前,红木家具行业年终盘点活动——2021“红品奖”红木品牌盛典在广州举行,揭晓了“年度开拓人物”、“年度开拓品牌”、“年度专业品牌”、“年度新闻”四大红木榜单。其中,表彰从艺术角度诠释红木家具文化, ...
【百科】
阅读更多
热门文章
最新文章
友情链接
- 企业需求拉动爆发,OpenAI今年底年化营收将冲700亿美元
- 厦门:汇聚百余家金融机构 拓展跨境合作商机
- IFA2026小鹏展台现场报道 车只是入口Physical AI才是主角
- 中秋选品|这款有机奶礼盒,盘活你的中秋生意!
- 汉阴县医共体总院胸痛中心高效联动基层卫生院成功救治急性心梗患者
- 福州平潭供电:驻岛值守防抗台风 筑牢离岛用电安全防线
- 扎根山乡担使命 小小银针解民忧——记汉阴基层医者刘繁
- 剪刀石头布家居解析FENDI CASA 2018设计趋势,诠释时尚雅居新定义
- 厦门打造高品质友好型养老服务体系
- 企业需求拉动爆发,OpenAI今年底年化营收将冲700亿美元
- 中秋选品|这款有机奶礼盒,盘活你的中秋生意!
- 林德收购中国宝武钢铁集团旗下中南钢铁空分装置,并签署供气协议
- 桂芳:桂香为伴 芳德育人
- 桂芳:桂香为伴 芳德育人
- 厦门:汇聚百余家金融机构 拓展跨境合作商机
- 唯一一场考试,赵勇和中国女排考砸了
- 常冰玉首夺排名赛冠军
- 中秋选品|这款有机奶礼盒,盘活你的中秋生意!
- 阿尔卑斯轻乳茶,多渠道突围,把利润握在手里!
- 2020亚洲社会设计展在鲁迅美术学院美术馆开展 图
- 茶饮红海找增量,柚小野冻冻茶凭差异化撬动终端高周转!
- 动力煤7月旺季行情还值得期待吗?
- 国际油价4月23日上涨 美油、布油均涨超1%
- 虽库存压顶,煤价仍有上涨空间
- IFA2026探展 先临三维让3D扫描告别线缆与贴点
- 石狮启动中秋国庆平价销售机制
- 国际油价4月23日上涨 美油、布油均涨超1%
- 大厂AI To B大战,这回战场为什么是办公?
- 千钧一发之际 他果断跳入冰冷河水中救人
- 国内线缆品牌百强榜发布:四大区域谁在领跑?
- 祖龙:以教育之光照亮边疆未来
- 香港保险公司怎么排?从授权名册到渠道APE
- 深化政企“双网格”融合服务体系
- 两部门发文加强光伏产业知识产权保护
- 高屋建瓴金屋之选:2018家具行业金屋奖名单重磅公布
- 服务战略新兴产业 融入绿色低碳发展——第十六届汽车动力系统年会长城润滑油专访
- 石狮“一景一秀”时尚文旅融合项目入选泉州文旅创新案例
- 中秋选品|这款有机奶礼盒,盘活你的中秋生意!
- 厦门打造高品质友好型养老服务体系
- 元气吽吽,大健康饮品经销商的低风险增长密码!
- 唯一一场考试,赵勇和中国女排考砸了
- 福州平潭供电:驻岛值守防抗台风 筑牢离岛用电安全防线
- 广州海关退运93吨甲醛超标进口家具-
- 阿里视频大模型Wan3.0正式上线,行业评价“稳定、真实、有质感”
- 福州平潭供电:驻岛值守防抗台风 筑牢离岛用电安全防线
- 年轻人为啥粉智能家居?谁不爱更有情调的生活
- 我国亮出油气能源新“家底”
- 虽库存压顶,煤价仍有上涨空间
- 2026IFA荣泰把按摩机器人推到健康机器人路口
- 石狮1—8月规上工业增加值同比增长8.6%